AIのコードレビューを二重化する——書いたAIとは別のAIに、欠陥を探させる運用
AIが書いたコードを、同じAIに「確認して」と頼んでも見落としはあまり減りません。 効くのは、生成する役と欠陥を探す役を分ける「二重化」——別のセッションで、しかも「バグを見つけるのが仕事」という前提のプロンプトでレビューさせることです。私たちが1人+AIで複数プロダクトの日次運用を回すなかで、機械的なチェック(型・lint・テスト)をすり抜けた不具合の多くはこの批評役を1枚挟んだ段階で表面化したので、実際に使っている構成と型を公開します。

TL;DR
- 生成したAIに自己レビューさせても、同じ前提・同じ思い込みのまま読むので見落としが残る
- 二重化=「機械のゲート(型/lint/build/test)」+「別AIの批評(欠陥を探す前提)」の2段
- 批評役は"良し悪しの評価"ではなく"欠陥の指摘"を仕事にする。プロンプトで役割を反転させる
- 増えるのはトークン代だけ。壊れたまま数日走る事故のコストより安い
なぜ自己レビューは弱いのか
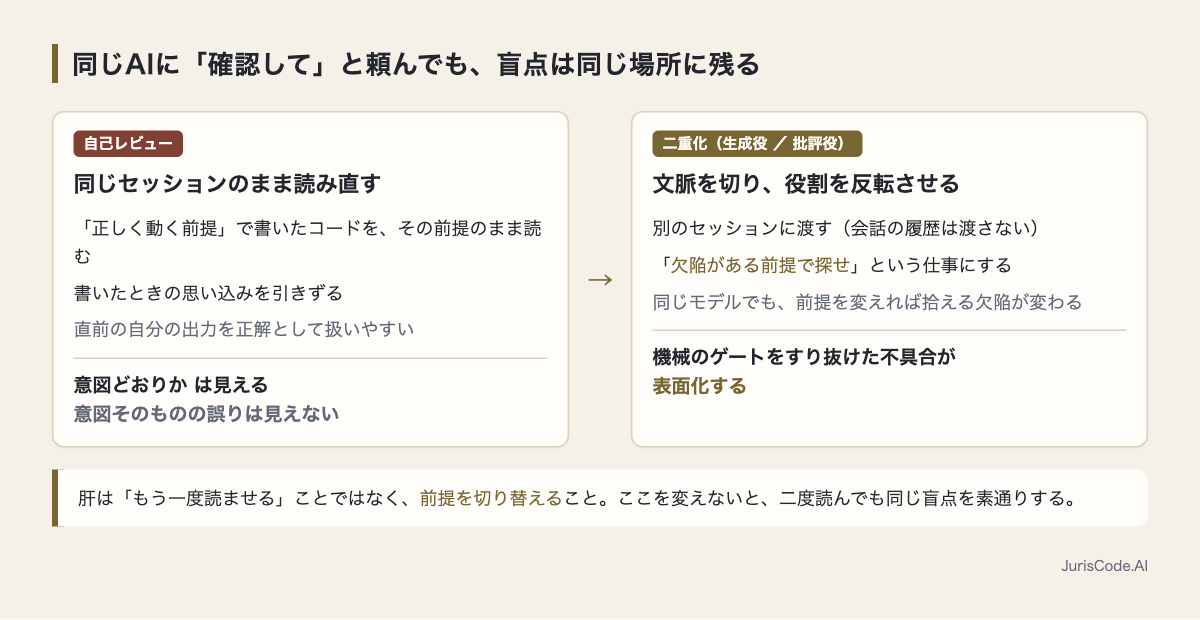
コードを生成したAIは、そのコードを「正しく動く前提」で書いています。同じセッションでそのまま「確認して」と頼むと、書いたときの思い込みを引きずったまま読み直すことになります。
これは人間のセルフレビューが弱いのと同じ構造です。自分の設計意図を知っている読み手は、「意図どおりに書けているか」は見られても、「その意図自体が間違っている可能性」には気づきにくい。
同じセッションには、もう一つ「直前までの会話」という強い文脈があります。生成役は「この方針で書こう」と合意した経緯を覚えているので、方針そのものを疑う動機がありません。疑うには、直前の自分の出力を否定する必要があるからです。
セッションを分けると、この構造が変わります。目の前のコードは「誰かが書いたもの」になり、否定するコストが消えます。批評役にコードと仕様だけを渡し、そこに至った議論を渡さないのは、この「否定しやすさ」を作るためです。
だから二重化の肝は、単にもう一度読ませることではありません。文脈と前提を切り、「欠陥がある前提で探せ」と役割を変えることです。ここを変えないと、二度読んでも同じ盲点を素通りします。
二重化の構成
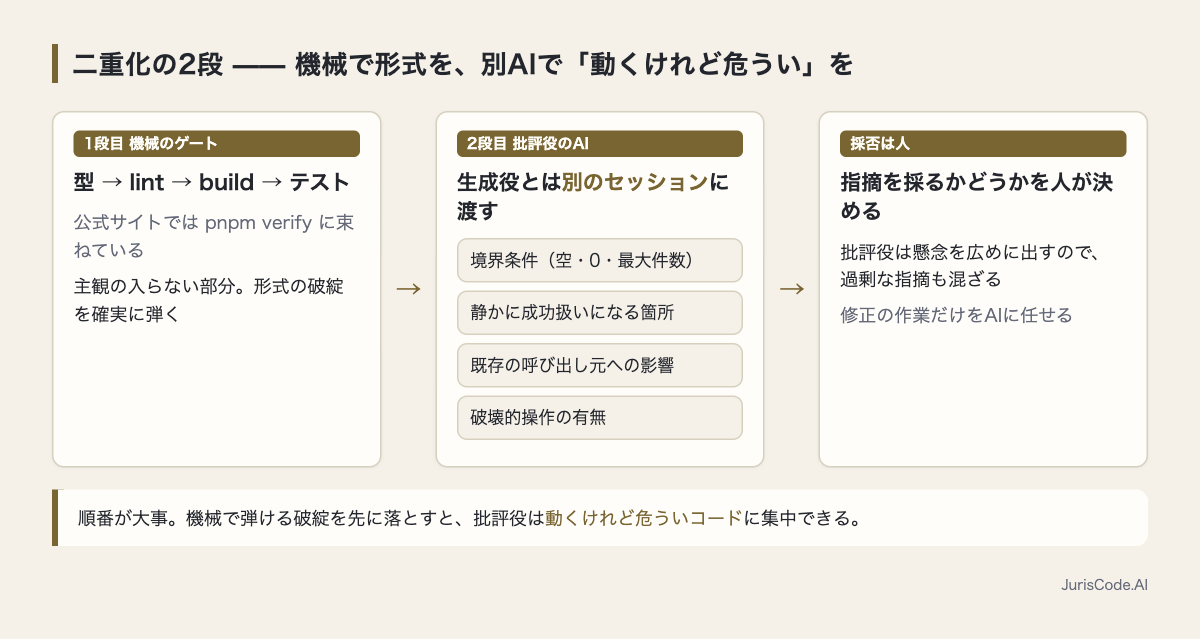
私たちのレビューは2段です。1段目は機械、2段目は別AIの批評で、順番も固定しています。
- 機械のゲート: 型チェック → lint → build → テスト(公式サイトでは
pnpm verifyに束ねています)。ここは主観の入らない部分で、形式の破綻を確実に弾きます - 批評役のAI: 1段目を通ったコードだけを、生成役とは別のセッションに渡し、「欠陥・境界条件・削除の巻き込みを探せ」という前提でレビューさせます
順番が大事です。機械で弾ける破綻を先に落としておくと、批評役は「動くけれど危ういコード」という、人とAIの目が本当に要る部分に集中できます。
実際の流れはこうです。生成役が変更を書き終えたら、まず1段目を回します。ここで落ちたものは批評役に渡しません——形式が壊れたコードを読ませても、指摘欄が表面的な直し方で埋まってしまうからです。
1段目が全部通ってから、変更後のファイルと「この変更で何をしたかったか」の1〜2行だけを別セッションに渡します。会話の履歴や、その設計にした言い訳は渡しません。渡す情報を絞るほど、批評役は仕様とコードのズレだけを見ることになります。
全体の自動化構成はClaude Codeで個人開発を自動化する構成にまとめています。
批評役のプロンプトの型
批評役に渡す指示は、評価ではなく反証を求める形にしています。「良いコードか」を聞くと、AIは肯定的な講評を返しがちだからです。
- 役割の反転: 「あなたはこのコードの欠陥を見つけるのが仕事です。問題がない、とは結論しないでください。少なくとも懸念点を挙げてください」
- 観点の固定: 「境界条件(空・0・最大件数)、失敗時に静かに成功扱いになる箇所、既存の呼び出し元への影響、破壊的操作の有無、の4点を必ず確認してください」
- 根拠の要求: 「指摘には、該当行と、それが問題になる具体的な入力・状態を添えてください」
3つ目が効きます。「具体的な入力・状態」を添えさせると、再現しない思いつきの指摘が減り、本当に危ない箇所だけが残ります。
もう一つ実務で効いたのは、指摘の数を先に縛らないことです。「重要なものを3つ挙げて」と頼むと、AIは3つに収まるよう重大度のほうを調整してきます。数は縛らず、代わりに「該当行」と「問題になる入力・状態」という根拠の形式だけを縛ると、根拠を書けない指摘が自然に落ちていきます。
逆に避けているのは、「この実装で合っていますか」と聞く形です。合っている/合っていないの二択にすると、AIは判断を返すために足りない前提を推測で埋めてしまいます。聞くのは判断ではなく、欠陥の候補と、その候補が壊れる条件です。
恒久的な前提(構成・禁止事項)は毎回書かず、CLAUDE.md側に置いています。
二重化で実際に捕まえた不具合の型
導入してから、批評役が繰り返し拾ってくれる不具合には型があります。機械のゲートは通るのに人が見落としやすい、ちょうど中間の層です。
- 静かな失敗: 外部処理が失敗しても例外を投げず、空の結果で正常終了してしまう箇所(この型は無言の失敗で詳しく扱いました)
- 境界条件の抜け: 0件・最大件数・空文字のときだけ壊れる分岐
- 削除の巻き込み: 一見無関係な修正が、既存の呼び出し元の前提を静かに変えてしまうケース
- 観測の取り違え: 状態を表さない属性を判定に使っていて、常に同じ値を返す箇所(タスクを検証できる単位に割るで触れた失敗と同根)
どれも「動いてはいる」ため、テストが無い箇所ではすり抜けます。批評役は、テストの網の目より細かいところを人の代わりに指さしてくれます。
4つに共通するのは、原因が「書いた人の頭の中では起こらないこと」だという点です。静かな失敗は、外部処理が失敗する未来を想定していないから残ります。境界条件の抜けは、動作確認に使うデータがいつも「ふつうの件数」だから残ります。
つまり、同じ頭で読み直しても見つかりません。前提を持たない読み手だけが、「ここは0件のとき何が返るのか」と聞けます。
拾った指摘は、直して終わりにせず、できるものはテストに変えています。批評役が書いた「壊れる入力・状態」は、そのままテストケースの入力になっているからです。
コストとやりすぎの線引き
二重化で増えるのはトークン代と、レビュー1回ぶんの待ち時間だけです。壊れたコードが本番で数日走り、原因の切り分けに半日かける事故に比べれば、桁違いに安い投資です。
一方で、レビューを三重・四重にしても効果は頭打ちになります。同じ観点で回数だけ増やしても、新しい欠陥は出てこないからです。増やすなら回数ではなく観点を変える——例えば「性能」「セキュリティ」「読みやすさ」と役割の違うレビューを分けるほうが拾える幅が広がります。
私たちは「機械ゲート+欠陥探しの批評1枚」を標準にし、外部にデータを書く処理や破壊的操作を含む変更のときだけ、観点の違う批評をもう1枚足しています。
この線引きは、変更が外に影響を残すかどうかで決めています。画面の中だけで完結する変更は批評1枚。外部にデータを書く処理や、削除・上書きを含む変更は、間違えたときに戻す手間が大きいぶん、もう1枚を足す側に置いています。
毎回「今回はどうしよう」と考えないで済むよう、線引きのほうを固定しておくのがコツです。全部に最大の手をかけないことも、運用を続けるための設計です。
よくある質問
Q. 同じAIに「もう一度厳しく見て」と頼むのではダメですか? A. 同じセッションだと、最初に書いたときの前提を引きずったまま読み直すので、盲点が残りやすいです。文脈を切った別セッションに、「欠陥を探すのが仕事」という反転した役割で渡すのが要点です。同じモデルでも、前提を変えるだけで拾える欠陥が変わります。
Q. テストがあれば二重レビューは要りませんか? A. テストは「想定した壊れ方」を守る網で、批評役は「想定していない壊れ方」を探す役です。役割が違うので両方要ります。むしろ批評役が指摘した箇所に、あとからテストを足していくと網が育ちます。
Q. レビュー結果をそのまま自動で反映してよいですか? A. 指摘の採否は人が決めるのが安全です。批評役は懸念を広めに出すよう仕向けているぶん、過剰な指摘も混ざります。採否の判断を人に残し、修正の作業だけをAIに任せる分担にしています。
コメント
#AI開発#AIコードレビュー#個人開発