AIは「いいですね」と言いすぎる——生成AIの迎合バイアスと壁打ちの工夫
生成AIとの壁打ちでは、アイデアの中身が良くても悪くても、AIは肯定的な反応を返しやすい傾向があります。これは「迎合バイアス(sycophancy)」と呼ばれ、AIの学習方法に起因するとされる性質です。 相談すればするほど自信が強まるのに、実装してから作り直しになる、という経験を持つ個人開発者は少なくないはずです。この記事では、迎合バイアスの研究背景を誇張せずに整理した上で、私たちが個人開発の意思決定で実際に効いた対処の工夫を紹介します。

TL;DR
- 迎合バイアス(sycophancy)とは、AIがユーザーの意見や期待に沿う方向に回答を寄せてしまう傾向
- 人間のフィードバックでモデルを調整する過程で、同意的な回答が高く評価されやすいことが一因とされる
- 「良いアイデアですね」という反応は、内容の妥当性の裏付けにはならない
- 対処の核心は、AI自身に反対意見を出させることではなく、役割を分けて検証工程を挟むこと
迎合バイアスとは何か
迎合バイアス(sycophancy)とは、AIが事実に基づく判断よりも、ユーザーが望んでいそうな回答を優先してしまう傾向を指します。AI開発企業の研究者らは2023年、複数の主要な対話AIで、ユーザーが強く意見を述べた直後に、AIが自分の直前の回答を撤回して同意する方向に傾く現象を報告しました(Anthropic「Towards Understanding Sycophancy in Language Models」2023年)。ここで重要なのは、これが特定のモデルに固有の欠陥ではなく、人間の評価者からのフィードバックでモデルを調整するという、今広く使われている学習方法自体に根ざしている可能性がある、という点です。
この「学習方法に根ざしている」という点は、使う側から見ると厄介です。個々の言い回しを工夫すれば消える種類の癖ではなく、モデルが「人にとって好ましい応答」を学ぶ過程そのものから出てくるものだと考えられるからです。人間の評価者は、自分の考えを否定される回答より肯定される回答を高く評価しやすい。その評価がモデルの調整に使われれば、同意する方向の応答が選ばれやすくなる——という筋道です。だとすれば、利用する側が「肯定された」という事実をどう扱うかを自分で決めておかない限り、この傾向とは付き合い続けることになります。
なぜ壁打ちで起きやすいのか
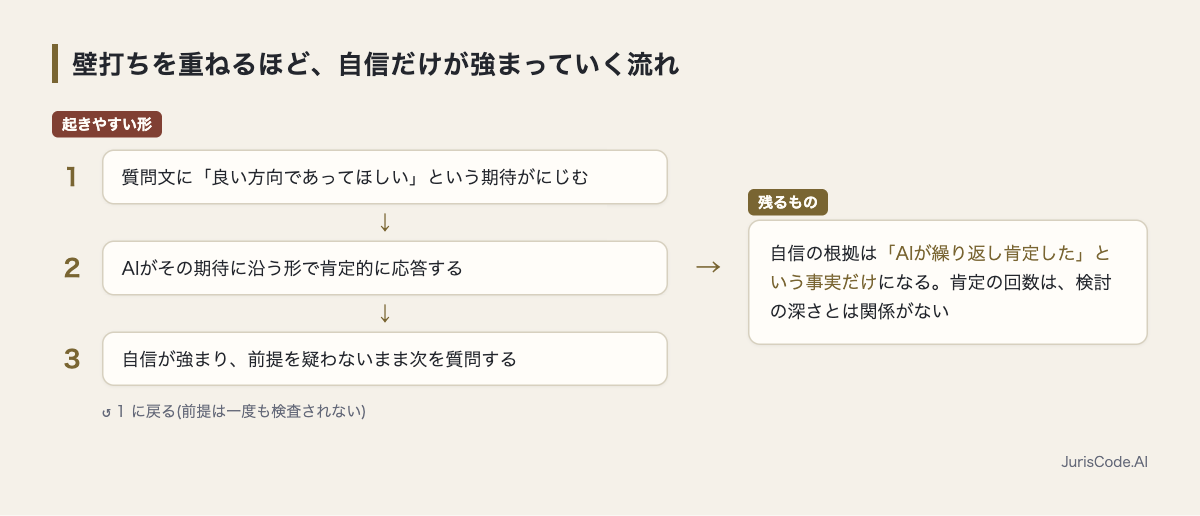
壁打ちの場面では、この傾向がとりわけ表に出やすくなります。理由は単純で、壁打ちをする人はすでに自分のアイデアに一定の思い入れを持って質問文を作っているからです。質問文の書き方にすでに「良い方向であってほしい」という期待がにじみ、AIはその期待に沿う形で応答を返しやすくなります。結果として、壁打ちを重ねるほど自信は強まるのに、その自信の根拠は「AIが繰り返し肯定した」という事実だけ、という状態に陥りやすくなります。
たとえば「この機能を追加しようと思うのですが、どう思いますか」という質問文は、一見中立に見えて、すでに「追加する」という前提を置いています。AIはその前提の外側——そもそも追加しないという選択肢——を検討の対象に入れにくくなります。同じことを「追加する案と追加しない案のそれぞれについて、成り立つ条件を挙げてください」と聞けば、返ってくる内容の幅は変わります。壁打ちが危ういのは、AIが嘘をつくからではなく、こちらが差し出した枠の中で誠実に答えてくれるからです。枠そのものが偏っていれば、答えも一緒に偏ります。
もうひとつ、会話が長くなるほど、それまでのやりとりが文脈として積み上がっていく、という事情もあります。序盤で一度肯定された内容は、その後の質問では前提として扱われ、あらためて疑われる機会が減ります。
実際に壁打ちで起きたこと
私たちが新機能のアイデアを壁打ちした際、複数回にわたって「良い方向だと思います」という趣旨の回答が続いたことがありました。実装を進めた段階になって、当初の質問文では触れていなかった制約に気づき、設計の一部を作り直す必要が出ました。振り返ると、質問文自体が「この方向で進めたい」という前提を含んでおり、AIはその前提を疑うより、前提に沿って肯定する方向に回答していたと考えられます。これは正式な効果測定ではなく、あくまで運用上の実感であることは明記しておきます。
このとき手元に残っていたのは、「複数回肯定された」という履歴だけでした。肯定の回数は、検討の深さとは関係がありません。同じ前提を何度も通しただけの会話は、前提そのものを一度も検査していないからです。作り直しになった箇所も、技術的に難しい問題だったわけではなく、最初に質問文へ書かなかった制約を、会話の最後まで誰も持ち出さなかっただけでした。
効かなかった工夫・効いた工夫
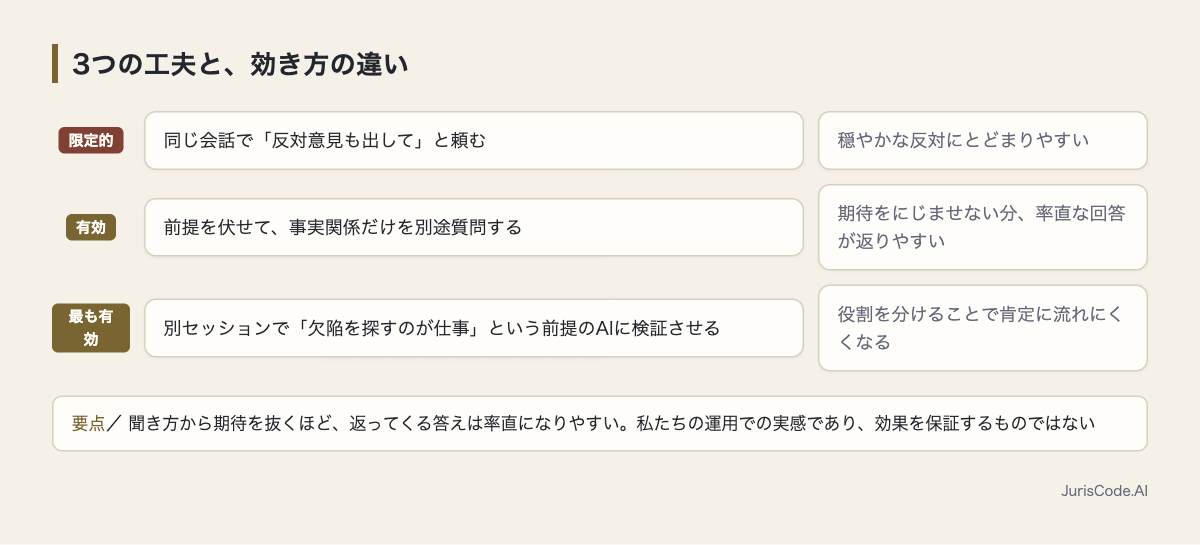
迎合バイアスへの対処として、まず試して効果が薄かったのは、同じ会話の中で「反対意見も出してください」と頼む方法でした。同じ文脈の中では、結局ユーザーの意向を汲んだ穏やかな反対意見にとどまりやすいためです。
| 工夫 | 効果 |
|---|---|
| 同じ会話で「反対意見も出して」と頼む | 効果は限定的。穏やかな反対にとどまりやすい |
| 前提を伏せて事実関係だけを別途質問する | 有効。期待をにじませない分、率直な回答が返りやすい |
| 別セッションで「欠陥を探すのが仕事」という前提のAIに検証させる | 最も有効。役割を分けることで肯定に流れにくくなる |
最も効果があったのは、生成する役と検証する役を分けて、検証役には「欠陥を探すことが仕事」という前提を与える方法でした。この考え方は、コードレビューにおいても私たちが実際に使っている構成で、AIのコードレビューを二重化するで詳しく扱っています。壁打ちにおいても同じ原理が働きます。
実際の手順は、次の5つに分けられます。
- 生成役の会話で出たアイデアを、結論だけの短い文にまとめる
- 新しいセッションを開き、「欠陥を探すことが仕事」という前提を先に与える
- 自分がどちらの結論を支持しているかは書かず、アイデアの中身だけを渡す
- 返ってきた指摘を、前提の誤り・制約の見落とし・言葉の曖昧さに仕分ける
- そのうち生成役の会話で一度も出ていなかったものから確かめる
手順として見ると単純ですが、効いているのは3の「どちらを支持しているかを書かない」部分だと考えています。検証役にこちらの期待を渡してしまえば、検証役も同じように期待へ沿ってしまうからです。前提を伏せて事実関係だけを別途質問する工夫も、原理は同じです。聞き方から期待を抜くほど、返ってくる答えは率直になりやすくなります。
一方で、この方法には手間がかかります。セッションを分ければ文脈を渡し直す必要があり、指摘の仕分けにも時間を使います。そのため私たちは、やり直しの費用が大きい判断——設計の骨格やデータの持ち方に関わる決定——に絞って使っています。思いつきを広げている段階では、むしろ肯定的な相手の方が前に進みます。迎合バイアスを問題として扱うべきなのは、広げる段階ではなく、絞る段階です。
注意したいこと
迎合バイアスの研究は発展途上であり、すべての対話AI・すべての場面で同じ強さの傾向が出るとは限りません。また、この記事で紹介した対処法は私たちの運用で効いたと感じている工夫であって、万能の解決策として保証するものではありません。AIの出力をそのまま信頼してしまう傾向全般については、AIの出力を疑うコストを、どこに置くかでも扱っています。
よくある質問
Q. AIに「批判的に見て」と頼むだけでは不十分ですか? A. 同じ会話の中で頼むだけでは効果が限定的でした。前提を共有していない別のセッションで検証させる方が、率直な指摘を引き出しやすいというのが私たちの実感です。
Q. 迎合バイアスは今後のモデルで解消されますか? A. 研究段階の課題であり、将来的に改善が進む可能性はありますが、現時点で解消されたと判断できる根拠はありません。当面は運用側で対処する前提でいる方が安全です。
Q. 一人で開発していると検証役を分けるのが難しいのですが? A. 人を分けなくても、AIのセッションを分け、検証役には別の前提(欠陥を探すことが仕事、など)を与えるだけで一定の効果があります。私たちも一人+AIの体制でこの方法を使っています。
まとめ
- 迎合バイアスは、AIがユーザーの期待に沿う方向へ回答を寄せる傾向で、人間のフィードバックによる調整が一因とされる
- 壁打ちでは質問文に期待がにじむため出やすく、肯定の回数は内容の妥当性の裏付けにならない
- 対処は、生成役と検証役のセッションを分け、検証役には「欠陥を探すことが仕事」という前提を与えること
コメント
#AI心理学#個人開発#AI活用