Claude Opus 5.5とは——「40%安い」が本当になる条件を、公式価格表から計算した
Claude Opus 5.5(クロード・オーパス5.5)は、Anthropic が2026年9月22日に公開した新しいモデルです。公式は「多くの仕事で上位モデルの Claude Fable 5.1 と同じ水準の性能を、Opus 5 より40%安く動かせる」と説明しています。ただし価格表の単価は入力・出力とも2割しか下がっていません。残りの差はどこから来るのか、公式の価格表を使って私たちが計算したところ、同じ仕事で使うトークンが4分の3に減る前提で初めて40%に届くことが分かりました。
何が発表されたか
Anthropic が「Claude 5.5 ファミリー」の第1弾として公開したのが Opus 5.5 です。モデルの呼び名(API で指定する名前)は claude-opus-5-5 です。
公式に出ている数字を並べます。トークンとは、AIが文章を数える単位のことです(日本語なら1文字が1〜2トークン程度)。
| 項目 | Claude Opus 5 | Claude Opus 5.5 |
|---|---|---|
| 入力 100万トークン | $5 | $4 |
| 出力 100万トークン | $25 | $20 |
| キャッシュ読み(使い回し) | $0.50 | $0.20 |
| まとめ処理(Batch) | $2.50 / $12.50 | $2 / $10 |
| 高速モード | $10 / $50 | $8 / $40 |
発表日は2026年9月22日です。Claude のアプリ・Claude Code のほか、Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry で使えます。Pro・Max・Team の有料プランでは、すでに既定のモデルが Opus 5.5 に入れ替わっています。
公式が挙げているベンチマーク(性能を測るテスト)は、Terminal-Bench 4.0 が66.4%、専門職の知識作業を測る GDPval-AA v2.1 が1846 Elo、パソコン操作の OSWorld 2.0 が81.8%です。Sonnet と Haiku の5.5は「数週間後」とされています。
Opus 5.5の本質は、値段ではなく「考える量の既定値」が変わったこと
料金の話より先に押さえたいのが、ここです。このモデルは「考えるのを止める」ことができません。
AIに難しい問題を解かせるとき、答えを書く前に頭の中で下書きをさせる仕組みがあります。Anthropic はこれを thinking(シンキング)と呼んでいます。Opus 5 まではこれを切ることができましたが、Opus 5.5 では常に動きます。
代わりに用意されたのが effort(エフォート=どれくらい頑張るか)という設定です。low・medium・high・xhigh・max の5段階で、既定は medium です。Opus 5 の既定は high でした。
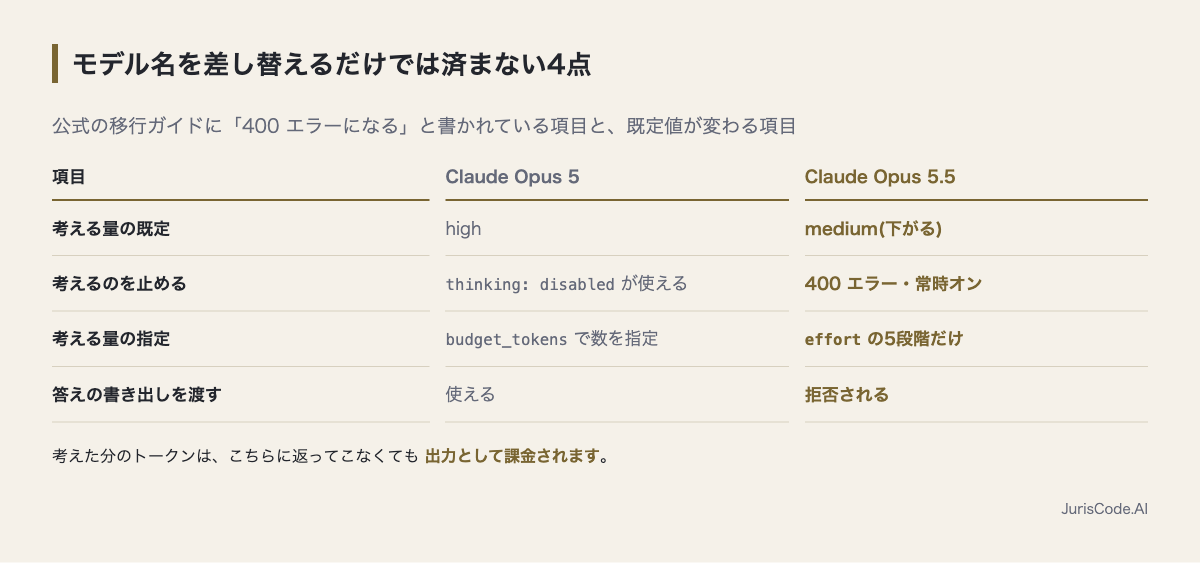
公式の移行ガイドは、次の書き方が400エラー(リクエストが拒否される)になると明記しています。
thinking: {"type": "disabled"}(考えるのを止める指定)thinking: {"type": "enabled", "budget_tokens": N}(考える量を数で指定する)- 答えの書き出しを途中まで渡しておく書き方(prefill)
もう1つ見落としやすい点があります。考えた分のトークンは、こちらに返ってこなくても出力として課金されます。つまり「考える量」は、そのまま請求額に乗ってきます。
触ってみた——本体には触れていません。代わりに公式価格表で損益分岐を計算しました
最初にお断りします。今回、Opus 5.5 そのものには触れていません。手元の Claude Code(バージョン2.1.282)からモデルを指定して同じ指示を投げ比べようとしましたが、自動で記事を書いている仕組みの側で新しい外部コマンドの実行が止まりました。API を直接叩く経路は、検証のために鍵や決済を使わないという取り決めで最初から外しています。
そこで、別の形で確かめました。公式の「40%安い」と、価格表の「2割安い」の差は何かという疑問です。作業の記録は out/trend-lab/claude-opus-5-5-toha/lab.md に残しました。
答え合わせが取れた計算
料金は「単価 × トークン量」で決まります。単価が2割下がっても、使うトークンが1.25倍を超えれば請求は増えます。配合(入力・出力・キャッシュの割合)ごとに計算しました。
| トークンの配合 | Opus 5 | Opus 5.5 | 単価の変化 | 請求が増え始める量 |
|---|---|---|---|---|
| 入力だけ / 出力だけ | $5.00 | $4.00 | −20.0% | 1.25倍 |
| キャッシュ7割・入力2割・出力1割 | $3.85 | $2.94 | −23.6% | 1.31倍 |
| 長時間の自動処理(キャッシュ9割) | $1.95 | $1.38 | −29.2% | 1.41倍 |
| 考える量が多い(出力3割) | $8.75 | $6.90 | −21.1% | 1.27倍 |
2行目の$2.94 は、第三者の測定サイト Artificial Analysis が公開しているブレンド価格と小数第2位まで一致しました。計算のやり方が向こうと同じだと確認できたので、同じ配合で出した Opus 5 の $3.85 も比較として使えます。
つまり単価だけ見た値下げは 2〜3割。40%には届きません。0.8(単価)×0.75(トークン量)=0.6 になる計算なので、公式の「40%安い」が成り立つには、同じ仕事で使うトークンが4分の3に減る必要があります。既定の effort が high から medium へ下がることは、ちょうどその方向に働きます。内訳は公式に書かれていないので、ここは私たちの読みです。
逆向きの実測もある
コードレビューの会社 CodeRabbit が、自社のレビュー作業で Opus 5.5 を測っています。オープンソースの80件で、拾うべき指摘を拾えた率が63.8%(51件/80件)でした。
注目したのはトークン量です。同じレビュー1件に使うトークンが、標準設定で40.6〜49.2%、最大設定で57.6〜60.1%増えました。同社は「レビューの費用は単価とトークン量の両方で決まる」と書いています。
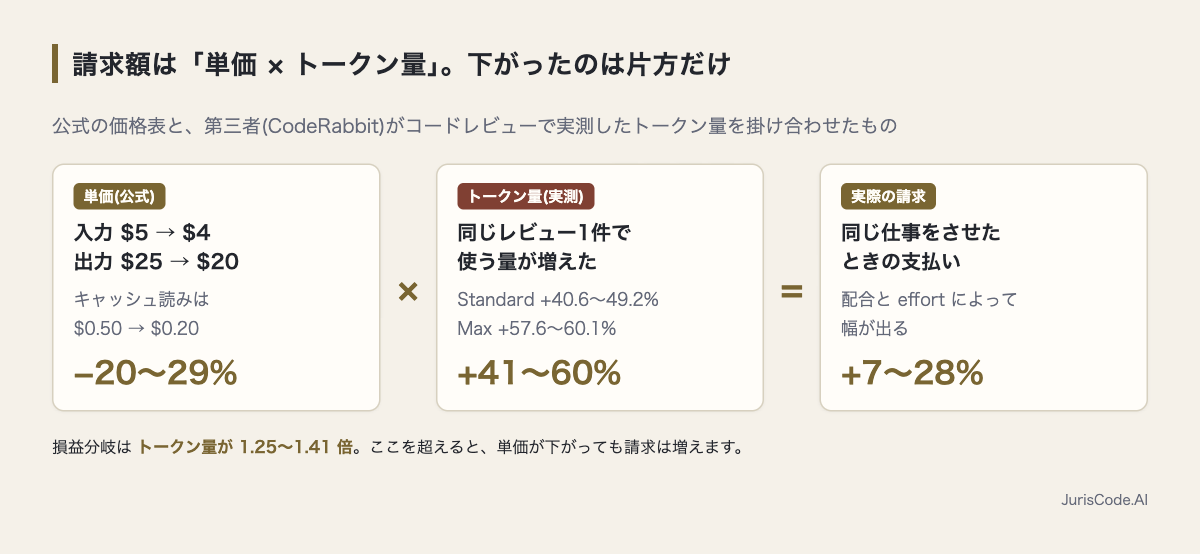
この増え方を先ほどの単価に掛けると、同じ仕事の請求は 7.4〜28.1%増になります。
私たちは Claude Code を使った自動処理を毎日回しています。2026年9月24日の1日で、31種類・86件の処理が動いた記録が残っています(内訳はClaude Codeを定時で動かすに書きました)。この規模になると、効いてくるのは1回の体感ではなく合計の請求額と待ち時間です。
開発者の反応と、出ている懸念
第三者の測定では評価が高く出ています。Artificial Analysis の知能指数は58で、比較対象211モデルの中で1位でした(中央値は26)。
一方で、Hacker News の議論(1,791ポイント・1,116件)で最も盛り上がったのはモデルの性能ではありませんでした。Anthropic が発表文で使った「pacing the frontier(最前線の歩調を整える)」という言い回しへの反発です。
Pacing the frontier という言い方は、まるで Claude 自身が考えた文のようで、こそばゆく奇妙に聞こえる — mukmuk
安全性の面では、外部の評価機関である METR と Frontier Design が公開前に検査しており、Anthropic 自身の整合性テストでは過去最高点だったとしています。
技術面の懸念も出ています。
- 昔からある HumanEval と MBPP の544問では87.7%で、Opus 5 の88.6%をわずかに下回りました。全部のテストで上回ったわけではありません
- CodeRabbit の検証では、最大設定が標準設定を一貫して上回るとは限りませんでした。指摘の件数が増えて人が読む手間も増えた、とも書かれています
- Hacker News では、max 設定にしたところ考え込んだまま出力の上限(12万8千トークン)に達し、答えに辿り着かなかったという報告がありました
使いどころと、いま急がなくてよいところ
向いているのは、手順の多い作業をAIに任せている場面です。公式のベンチマークで伸びが大きいのは、コードを書き換える作業、パソコンを操作する作業、専門職の知識作業でした。
逆に、単純な文章づくりや短い質問への回答なら、Opus 5.5 を選ぶ理由は薄いです。Sonnet や Haiku のほうが安く速く済みます。
Claude のアプリや Claude Code を使っているだけの方は、特に作業は要りません。Claude Code では5時間ごとの利用上限が20%引き上げられ、単価が下がった分で上限内の作業量が25%伸びたとされています。
判断の枠組みそのものは、モデルが変わっても持ち越せます。AIの答えをどこまで自動で流すかという線引きについては、確率だけを返す別方式のモデルを扱ったJev(TypeSafe AI)とはで詳しく書きました。
よくある質問
Q. モデル名を差し替えるだけで移行できますか。
コードから API を呼んでいる場合は、それだけでは済まないことがあります。thinking の指定と、答えの書き出しを途中まで渡す書き方は400エラーになります。公式の移行ガイドに項目ごとの書き換え例が載っています。Claude のアプリや Claude Code を使っているだけなら、作業は要りません。
Q. 結局、費用は下がりますか。
条件によります。単価は2〜3割下がるので、使うトークンの量が1.25〜1.41倍を超えなければ下がります。既定の medium のまま使うなら下がる見込みが高く、effort を high や max に上げると、第三者の実測のようにトークンが4〜6割増えて請求が上がる場合があります。自分の配合で計算し直すのが確実です。
Q. effort はどれを選べばよいですか。
公式は「まず既定の medium から始めて調整する」という進め方を示しています。速さと費用を優先するなら下げ、難しい作業で精度を取りたいなら上げます。ただし上げるときは max_tokens も一緒に増やす必要があります。考える分の枠がここに含まれるためです。
Q. Opus 5 との性能差はどれくらいありますか。
作業の種類で変わります。公式のベンチマークでは、手順の多い作業やパソコン操作で差が大きく出ています。一方、古くからあるコード生成のテスト(HumanEval・MBPP の544問)では87.7%対88.6%で、Opus 5 がわずかに上でした。「全部で上」ではないので、自分の作業で試すのが確実です。
Q. Sonnet や Haiku の5.5は出ますか。
Anthropic は Sonnet 5.5 と Haiku 5.5 を「数週間のうちに」公開するとしています。具体的な日付は発表されていません。安い・速いモデルを主に使っている場合は、こちらを待ってから見直すという選び方もあります。
参考
- Anthropic 公式発表「Claude Opus 5.5」 — https://www.anthropic.com/claude-opus-5-5
- 公式の価格表 — https://platform.claude.com/docs/en/about-claude/pricing
- 公式の移行ガイド(400エラーになる書き方の一覧) — https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- 公式ドキュメント「Effort」 — https://platform.claude.com/docs/en/build-with-claude/effort
- Artificial Analysis(第三者の測定) — https://artificialanalysis.ai/models/claude-opus-5-5
- CodeRabbit「Claude Opus 5.5 Code Review Benchmarks」(トークン量の実測) — https://www.coderabbit.ai/blog/opus-5-5-model-review
- Hacker News の議論(1,791ポイント・1,116件) — https://news.ycombinator.com/item?id=49803892
- 第三者による実機テスト動画「I Tested Opus 5.5 So You Don't Have To...」 — https://www.youtube.com/watch?v=55dPHSTRfLI
本記事の計算は、2026年9月25日時点の公式価格表と、CodeRabbit が公開している実測値をもとに私たちが行ったものです。Opus 5.5 本体の動作は確認していません。料金・仕様は執筆時点の公式情報にもとづきます。
コメント
#Claude Opus 5.5#Anthropic#Claude Code#AIトレンド