Jev(TypeSafe AI)とは——文章を書かない「判断だけのAI」を手元で試した
Jev(ジェブ)は、文章を一切書かず、こちらが先に決めておいた選択肢のどれかと、その確率だけを返すAIです。米 TypeSafe AI が2026年9月15日に早期アクセスとして公開しました。公式の料金は入力100万トークンあたり0.042ドル、出力トークンは無料、応答は70〜500ミリ秒とされています。本体は順番待ちの登録が必要なので今回は触っていません。代わりに、同じAPI仕様で作られたオープンソースの「Kev」を手元のMacで動かし、日本語の問い合わせで確かめました。
何が発表されたか
TypeSafe AI が「System One モデル」と呼ぶ新しい種類のモデルの第1弾が Jev です。作ったのは Diogo Almeida 氏。OpenAI で ChatGPT の開発に関わり、RLHF(人の好みでAIを調整する手法)の共同考案者とされる人物です。
公式に出ている数字を並べます。
| 項目 | 公式が示している内容 |
|---|---|
| 発表 | 2026年9月15日・早期アクセス(順番待ち登録制) |
| 料金 | 入力100万トークンあたり0.042ドル / 出力トークンは無料 |
| 応答時間 | 70〜500ミリ秒(公式ドキュメント) |
| 学習方法 | RLCD(判断の確率を正しく合わせるための強化学習) |
| 重みの公開 | なし。ホスティングされたAPIのみで、自前で動かすことはできない |
| 比較の主張 | 自社のデモで GPT-5.6 Terra 比 193.6倍速い・444.6倍安い(0.114秒 対 8.566秒) |
比較の数字は TypeSafe 自身が走らせたもので、第三者による検証はまだ揃っていません。ここは割り引いて読む必要があります。
Jevの本質は「AIの答えを、人ではなくプログラムが受け取る」こと
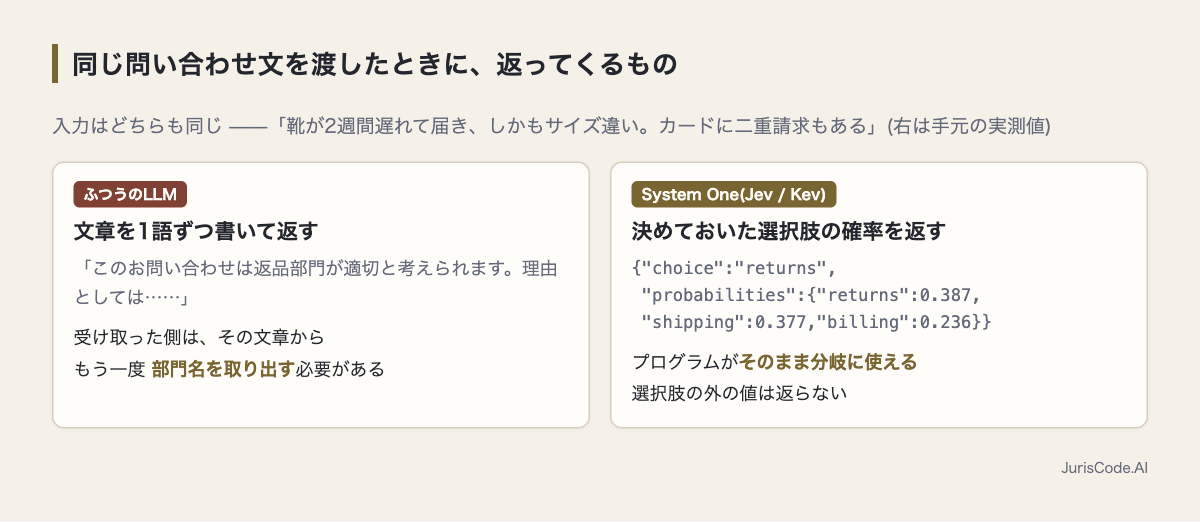
いつも使っている ChatGPT のようなAI(LLM)は、文章を1語ずつ作って返します。人が読むにはこれで良いのですが、プログラムに渡すときに一手間かかります。
返ってきた文章から、もう一度「結局どれなのか」を取り出さなければならないからです。JSON の形で返すよう頼んでも、時々かたちが崩れます。そこを直すための後処理が、地味にどのシステムにも入っています。
Jev はこの工程を丸ごと無くします。返ってくるのは最初から選択肢の名前と確率だけで、決めた選択肢の外の答えは構造上出てきません。
質問のかたちは3つだけ
送るのは「state(判断の材料になる文章やJSON)」と「questions(聞きたいこと)」の2つです。質問は3種類しかありません。
| 型 | 聞き方 | 返ってくるもの |
|---|---|---|
| Choice | 最大255個の選択肢から1つ選ばせる | 選ばれた名前・各選択肢の確率・確信度 |
| Score | 低い順に並べた段階で採点させる | 平均の段階・凡例・確率・確信度 |
| Noul | 「この記述は本当か」を問う | 0〜1の確率(はいの確からしさ) |
複数の質問を1回のリクエストにまとめて入れられます。質問どうしは互いの答えを見られないので、「部門はどこか」の答えが「緊急か」の答えに引きずられません。
「幻覚が起きない」の正確な意味
Jev の説明でいちばん誤解されやすいのがここです。幻覚(AIが事実でないことを作ってしまうこと)が起きないというのは、決めた選択肢の外の値が返らない、という意味だけです。
中で間違えることはあります。KDnuggets の解説記事はこの点を名指しで指摘していて、「正解が Technical だったときに Billing を選ぶことは依然としてありうる」と書いています。型が守られることと、答えが合っていることは別の話です。
確率が返ると、「どこまで自動で流すか」を先に決められる
ここが業務に効く部分です。文章を返すAIは「おそらく返品部門です」と言い切ってしまい、どれくらい迷ったのかが表に出ません。確率が付くと、その迷いが数字として見えます。
公式ドキュメントが示している扱い方は3つです。確信度が高ければそのまま次の処理へ流し、真ん中なら人に確認してもらい、低ければ最初から人にまわす。
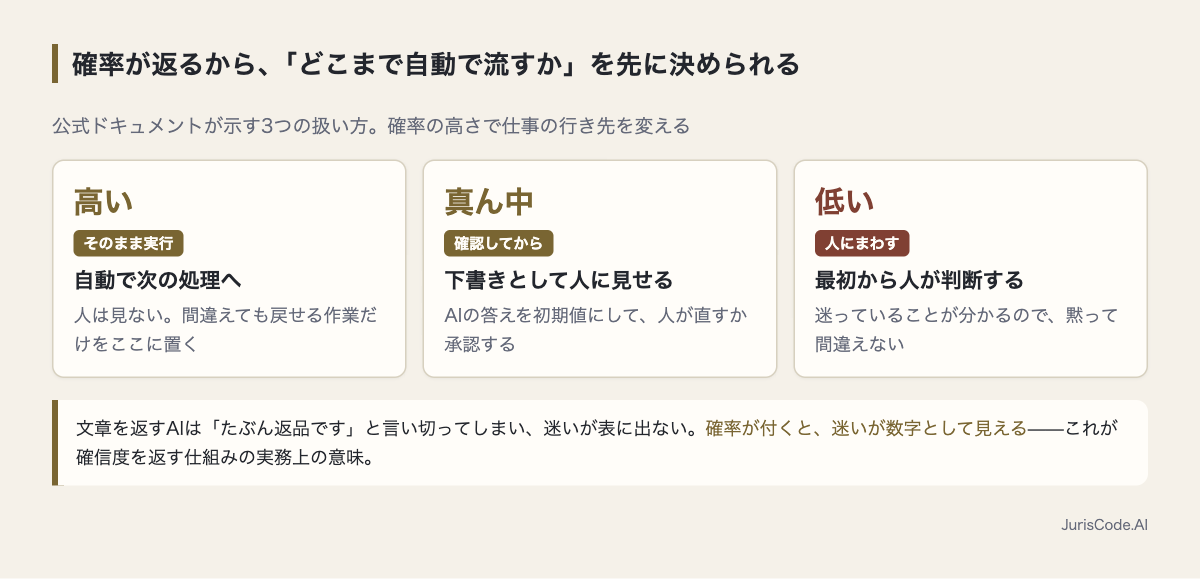
この線引きは、AIの出力をどこまで信じるかという設計そのものです。人はAIの答えがもっともらしく見えるほど検証を省きます(自動化バイアス)。その話はAIの出力を疑うコストを、どこに置くかで整理しました。確率が最初から付いてくるモデルは、この線引きを勘ではなく数字でやれるようにします。
手元で触ってみた——本体ではなく、同じ仕様のOSS「Kev」を動かした
Jev 本体は早期アクセスの順番待ち登録が要ります。私たちは自動で回している記事づくりの取り決めとして、検証のための会員登録・決済はしないと決めているため、Jev そのものには触っていません。
代わりに動かしたのが Kev です。Jared Palmer 氏が公開しているオープンソース(Apache-2.0)で、Qwen3.5 をもとに作られており、API の形が TypeSafe の System One とそろえてあります。TypeSafe 公式の Python SDK の接続先を差し替えるだけで、そのまま自分のパソコンに向けられます。
作業記録は out/trend-lab/jev-typesafe-ai-toha/lab.md に残しました。使ったのは一家の中でいちばん小さい Kev-0.8B です。
入れるのは速い。待つのは重みのダウンロード
| やったこと | 実測 |
|---|---|
uv sync --extra serve(依存の導入) | 32秒 |
| 重み不要のテスト104件 | 25.18秒 |
| サーバー起動〜応答できるまで | 約4分半 |
| 英語の例・初回 / 3回目 | 1,726.8ms / 111.0ms |
導入そのものは1分もかかりません。時間を食ったのは土台モデル(Qwen3.5-0.8B-Base)のダウンロードで、起動から応答可能まで約4分半かかりました。回線を実測すると約430KB/s だったので、細い回線ではここだけで数十分になります。大きい 4B や 9B を選ぶなら、その分をあらかじめ見ておく必要があります。
3回同じリクエストを投げたところ、確率は小数点以下4桁まで毎回まったく同じでした。同じ入力なら同じ答えが返る、という性質は分岐処理に使ううえで効きます。
日本語でそのまま動いた。ただし答えが英語版とずれた
「靴が2週間遅れ・サイズ違い・カードに二重請求」という同じ内容の問い合わせを、英語と日本語で投げ比べました。設定はいじっていません。
日本語でも問題なく動き、選択肢の説明も採点の凡例も日本語のまま返ってきました(178.6ms)。ところが第1候補が入れ替わりました。英語では returns が0.387、shipping が0.377、billing が0.236。日本語では billing が0.538で首位に立ちました。
どちらも確信度は低い値でした(0.081 と 0.307)。もっとも、この問い合わせには返品・配送・請求の3件が混ざっているので、モデルが迷うのは妥当ともいえます。
確信度は飾りではなかった
そこで、論点を1つに絞った日本語の問い合わせを追加で投げました。「同じ注文番号で3,200円が2回引き落とされている。1回分を返金してほしい」という請求だけの文面です。
結果は billing で確率0.893、確信度は0.307から0.839へ上がりました。入力があいまいなときは迷い、はっきりしているときは迷わない。確信度が入力の曖昧さをきちんと拾っていることが、最小モデルでも確認できました。
外した点も書いておきます。丁寧な依頼文なのに「怒っている度合い」が高めに出ました。Kev-0.8B は一家の中で最小・最弱(未学習ソースでの精度0.652〜0.684)なので、これを Jev の実力と読んではいけません。あくまで「System One というかたちが日本語でどう振る舞うか」を見るための試運転です。
開発者の反応と、出ている懸念
反応は速く、公開直後は API の負荷でサービスが一時的に応答できなくなったと TechCrunch が報じています。
- Vercel の技術者 Pranit Sharma 氏は、コマンドの安全判定に使っていた OpenAI のモデルを Jev に差し替えたところ「5倍から18倍速く」なり、精度も上がったと述べています。
- Hacker News では初日に256件のコメントが付きました。支配的だった見方は「非常に優秀なゼロショット分類器・ルーターである」という評価で、同時に「フロンティアモデルと呼ぶのは言い過ぎだ」という声が中心でした。
- 開発者の Armin Ronacher 氏は、確信度の解釈を利用者側が引き受ける点に触れ、「50%の確率で返ってきたら、それはコイン投げかもしれない」と指摘しています。
懸念のうち、いちばん具体的なのはベンチマークの立て付けです。KDnuggets は、精度評価の正解データがフロンティアモデルの出力から作られていて独立に検証された正解ではない、と指摘しています。
興味深いのは、Kev 側が自分の README で同じ慎重さを保っていることです。Kev-9B は未学習ソースで0.822、Jev は0.857。TypeSafe の公開評価セットでは Kev-9B が0.809、Jev が0.891。そのうえで「Jev がどのデータで学習したか分からないので、これは統制された比較ではない」と明記しています。数字を出しつつ数字の限界も書く姿勢は、一次資料としての信頼度を上げています。
使いどころと、いま手を出さないほうがよいところ
向いているのは、答えの候補があらかじめ決まっていて、量が多く、速さが要る判断です。
- 問い合わせの振り分け、優先度付け
- 入力内容の安全判定(このコマンドを実行してよいか、など)
- 大量の文書に対するラベル付け・スコア付け
- AIエージェントが次にどの道具を使うかの選択、作業が終わったかの判定
向いていないのは、文章を書く・要約する・理由を説明する仕事です。Jev はそもそも言葉を出しません。知識そのものを問う用途も土俵が違います。
注意点は4つあります。第一に、重みが公開されておらず自前で動かせないため、止まったときの代替経路を用意しておく必要があります。第二に、選択肢の並び順で答えが動く可能性は残ります(Kev には並び順を試す専用のAPIが最初から付いています)。
第三に、確信度の閾値は必ず自分のデータで決めることです。Kev の README によれば、誤りを5%に抑える前提で自動化できる判断の割合は Kev で0.45〜0.57、Jev で0.70。同じ「高い確信度」でも安全に流せる量は大きく違います。
第四に、これは道具ではなく設計の問題です。判断をAIに預ける範囲を決めるのは、注意書きではなく検査のかたちに落とす必要があります。この考え方はAIエージェントが指示を守らない理由で実測とともにまとめています。
いまの段階では、「置き換える」より「1つの判断だけを切り出して、いまの処理と並べて走らせ、答えのずれを測る」のが現実的です。確率が返るモデルは、そのずれの測定自体がやりやすくなっています。
よくある質問
Q. Jev は無料で使えますか。
出力トークンは無料ですが、入力トークンには課金されます。公式の価格は入力100万トークンあたり0.042ドルで、TypeSafe は自社のベンチマークでの1判断あたりの平均をおよそ0.0004ドルと見積もっています。利用は早期アクセスのため、まず順番待ちの登録が必要です。
Q. 読み方と名前の意味は何ですか。
日本語では「ジェブ」と読まれています。「System One」という呼び名は、心理学者ダニエル・カーネマンの『ファスト&スロー』に出てくるシステム1(速くて直感的な判断)に由来します。じっくり考える仕事ではなく、熟練者なら数秒で決められることを大量にさばく役回り、という位置づけです。
Q. LLM の代わりになりますか。
なりません。役割が違います。Jev は文章も説明も出さないので、書く・まとめる・答えるという仕事はこれまでどおり LLM の担当です。想定されているのは、大きなアプリの中に置く「速い判断の層」としての使い方です。
Q. 日本語で使えますか。
今回 Kev で試した範囲では、追加の設定なしに日本語の入力と日本語の選択肢で動きました。ただし同じ内容でも英語と日本語で第1候補が入れ替わる例が出ています。Kev の README も、別の言語で使うなら数百件のラベル付きデータで追加学習するほうがプロンプトを工夫するより効く、と書いています。Jev 本体の日本語性能は今回確認していません。
Q. 登録しないで雰囲気を確かめる方法はありますか。
オープンソースの Kev が同じAPI仕様なので、手元で動かせば「決めた選択肢の確率が返ってくる」という体験自体は再現できます。Hugging Face 上にブラウザで試せるデモも公開されています。ただし精度は Jev と同じではないため、性能の判断材料にはなりません。
参考
- TypeSafe AI 公式発表「Introducing System One Models & Jev」 — https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI 公式サイト — https://typesafe.ai
- TypeSafe AI 公式ドキュメント — https://docs.typesafe.ai/
- TechCrunch「A new kind of AI model from a ChatGPT inventor is thrilling developers」(2026-09-18) — https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/
- KDnuggets「What Everyone Is Getting Wrong About TypeSafe AI's Jev」 — https://www.kdnuggets.com/what-everyone-is-getting-wrong-about-typesafe-ais-jev
- Kev(今回動かしたオープンソース・Apache-2.0) — https://github.com/jaredpalmer/kev
- 解説動画「Jev by TypeSafe AI: System One Model Explained With Live Demos」 — https://www.youtube.com/watch?v=QKafJHkYrRE
本記事の実測値は、2026年9月23日に Apple Silicon の Mac 上で Kev-0.8B を動かして得たものです。Jev 本体の数値は含みません。記載の料金・仕様は執筆時点の公式情報にもとづきます。
コメント
#Jev#TypeSafe AI#AIトレンド#業務自動化